Höchstleistungsrechenzentrum Stuttgart


Bis Ende der 2010er Jahre entwickelten und validierten Wissenschaftler:innen europaweit neue Software zur Simulation von Systemen im Erdinneren. Sie erkannten jedoch, dass sie mehr Rechenleistung benötigten, damit diese Modelle den Umfang und die Auflösung erreichen konnten, die zur Beantwortung wichtiger wissenschaftlicher Fragen erforderlich waren. Parallel dazu erreichten Höchstleistungsrechner, wie sie beispielsweise vom HLRS und seinen Partnern im Gauss Centre for Supercomputing betrieben werden, eine beispiellose Leistungsfähigkeit.
Geowissenschaftler:innen erkannten das Potenzial von Supercomputern, jedoch mit einem Haken: Die von ihnen verwendeten Programme liefen nicht gut auf großen, hochgradig parallelisierten Systemen. Um die erforderliche Genauigkeit bei einer Geschwindigkeit zu erreichen, die eine Reaktion auf Naturkatastrophen in Echtzeit ermöglichen würde, mussten sie die Leistung ihrer Codes verbessern.
Aus diesem Bedarf heraus enstand im Jahr 2018 eine internationale wissenschaftliche Kollaboration – ChEESE, das Center of Excellence for Exascale in Solid Earth. Die bereits zweite Projektphase – ChEESE-2P – wird von der EuroHPC Joint Undertaking noch bis Ende 2026 gefördert. In den vom Barcelona Supercomputing Centre (ChEESE) und dem Consejo Superior de Investigaciones Científicas (ChEESE-2P) koordinierten Projekten haben Geowissenschaftler:innen und Expert:innen für Höchstleistungsrechnen gemeinsam wissenschaftliche Codes für Simulationen der Erdoberfläche und des Erdinneres (die Geosphäre) verbessert. Nur so können sie das Potenzial europäischer HPC-Systeme künftig ausschöpfen.
Bislang konzentrierten sich die ChEESE-Projekte auf die Skalierung und Optimierung von elf wissenschaftlichen Codes für Simulationen der Geosphäre. Expert:innen identifizierten bei der Leistungsoptimierung Engpässe und erzielten Skalierungs- und Effizienzfortschritte. Aus ChEESE und ChEESE-2P resultierten 32 wissenschaftliche Fachartikel. Die Projekte trugen zur Entwicklung von Rechenworkflows bei, die sich bei der Vorhersage und Bewältigung von Naturkatastrophen effektiver einsetzen ließen.
Das HLRS ist nicht nur Partner im ChEESE-Projekt, sondern auch am europäischen Konsortium POP beteiligt, dem EuroHPC Performance Optimization and Productivity Center of Excellence. In Zusammenarbeit mit anderen führenden Hoch- und Höchstleistungsrechenzentren waren Experten des HLRS an der Entwicklung von Analysewerkzeugen zur Bewertung der Softwareleistung beteiligt. Diese setzen sie zudem regelmäßig ein, um die Code-Leistung auf HPC-Systemen zu verbessern.
POP ist ein kostenloser Service für HPC-Anwender aus Wissenschaft und Industrie. Nach der Einbindung in wissenschaftliche Programme überwachen die Analysewerkzeuge von POP wichtige Leistungsindikatoren wie Lastverteilung sowie Parallelitäts-, Kommunikations-, Skalierungs-, Serialisierungs- und Datenübertragungseffizienz. Die HPC-Experten von POP nutzen die Ergebnisse, um Engpässe zu identifizieren und Empfehlungen auszusprechen, die die Effizienz des Programms und dessen Skalierbarkeit auf größere Rechensysteme verbessern.
Da die EuroHPC Joint Undertaking europaweit mehrere groß angelegte Höchstleistungsrechnersysteme in Betrieb genommen hat, empfiehlt es nun allen Nutzer:innen dieser Systeme, ihre Codes zur POP-Analyse einzureichen. Dieser Schritt stellt nicht nur sicher, dass die Nutzer:innen einen größeren wissenschaftlichen Nutzen aus der verfügbaren Rechenzeit ziehen, sondern auch, dass die EuroHPC-Systeme so produktiv wie möglich sind.
Während der ChEESE-Projekte war die Leistungsfähigkeit nicht nur eine technische Angelegenheit. Darüber hinaus haben sie einen Beirat aus kommunalen Beamt:innen, die von potenziellen Naturkatastrophen bedroht sind, ins Leben gerufen. Vertreter:innen von Katastrophenschutzbehörden in Norwegen, Island und Italien gaben beispielsweise konkrete Empfehlungen dazu ab, welche Arten von Vorhersageinstrumenten für sie am nützlichsten wären.
„Der italienische Zivilschutz könnte beispielsweise an ChEESE herantreten, um zu beschreiben, welche Art von Landkarten er benötigt und welche Auflösung erforderlich ist“, sagte Dr. Jose Gracia, Leiter der Abteilung „Scalable Programming Models and Tools“ am HLRS. „Die in ChEESE verankerte Zusammenarbeit bedeutet, dass echte Anwender Interesse an unseren Ergebnissen haben.“
In seiner aktuellen Förderphase weitete ChEESE-2P seinen Fokus über die Leistungsoptimierung einzelner Codes hinaus auf die Workflows aus, in die HPC-Simulationen in Krisensituationen integriert werden müssen. Um beispielsweise auf einen Tsunami zu reagieren, könnten seismische Sensoren einen Alarm auslösen und erste Messungen vornehmen. Die von ihnen erfassten Daten müssen automatisch in ein Modell eingespeist werden, das dann die Simulation schnell analysiert, um das Ausmaß der Gefahr vorherzusagen. In schweren Fällen müssen zuverlässige, leicht interpretierbare Ergebnisse unverzüglich an die Behörden weitergeleitet werden, die für die Warnung der Bevölkerung und den Schutz ihrer Sicherheit zuständig sind. Um einen solchen Arbeitsablauf effizient umzusetzen, muss ein Rechenworkflow entworfen werden, der Daten zügig durch mehrere Analyse- und Verarbeitungsstufen leitet.
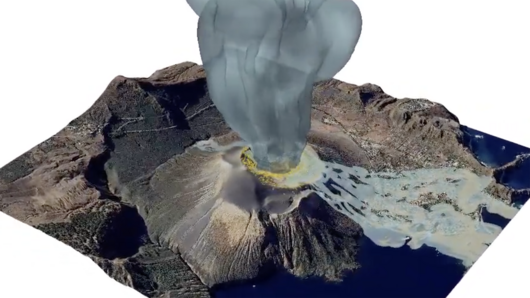
Ein ChEESE-Simulationsfall wurde von Mattia de' Michieli Vitturi und Esposti Ongaro am Nationalen Institut für Geophysik und Vulkanologie (INGV) in Italien geleitet. Mit Blick auf den Vulkan Campi Flegrei in Neapel konzentriert sich ihr Team auf Methoden zur Simulation von Mehrphasenströmungen bei sogenannten phreatischen Vulkanausbrüchen. Solche Ereignisse auftreten, wenn heißes Magma das Grundwasser auf hohen Druck erhitzt, was zu einer Explosion führt. Ziel ist es, ein Frühwarninstrument zu entwickeln, das die Gefahr einer phreatischen Eruption erkennt und wahrscheinliche Eruptionsszenarien vorhersagt.
Vitturi und Ongaro nutzen für ihre Simulationen den ChEESE-2P-Flaggschiff-Code OpenPDAC. Sie wollten diesen für das EuroHPC-System LUMI im Hinblick auf dringende Rechenanwendungen optimieren. Der Code führt ein Ensemble paralleler Simulationen durch, um den Parameterraum zu durchsuchen und das wahrscheinlichste Szenario für einen Ausbruch zu ermitteln. Der Workflow umfasst zudem Vorverarbeitungsschritte wie die Einstellung und Generierung von Parametern sowie die Bearbeitung von Netzgittermodellen. Bei der Nachbearbeitung der Ensemble-Simulation werden die Simulationsergebnisse in Grafiken und Videos visualisiert. Die Jobplanung und die Zuweisung von Rechenressourcen sind ebenfalls wesentliche Bestandteile des Arbeitsablaufs. Obwohl die Vor- und Nachbearbeitungsschritte nur einen sehr geringen Anteil an der gesamten Rechenzeit ausmachen, sind sie entscheidend für die Korrektheit und Leistungsfähigkeit der Simulationen sowie für die Interpretation der Simulationsergebnisse.
Das Team für Leistungsoptimierung am HLRS arbeitete mit Kolleg:innen vom INGV zusammen, um die bei der Vor- und Nachbearbeitung verwendeten Python- und Bash-Skripte zu verbessern. Nach einer ersten Korrektheitsprüfung mit Tools wie Pylint und Shellcheck identifizierten die Forscher in Testläufen den zeitaufwändigsten Abschnitt.
Der Einsatz des Numba-Moduls zur Konvertierung von Funktionen, die Gittermodelle verarbeiten, in Maschinencode verhalf in der Vorverarbeitungsphase zu einer Beschleunigung von etwa 27 Prozent. Bei der Nachbearbeitung schlug das HLRS zudem vor, die Videogenerierung von der CPU auf die GPU zu verlagern, und beschleunigte diesen Prozess um das Tausendfache.
Derartige Leistungssteigerungen tragen dazu bei, den Einsatz von OpenPDAC in dringenden Rechenumgebungen praktikabler zu machen. Sie verdeutlichen zudem, wie wichtig HPC-Fachwissen ist, wenn wissenschaftliche Innovationen für den Schutz von Eigentum und Menschenleben eingesetzt werden.
— Christopher Williams

Als Mitglied des Gauss Centre for Supercomputing ist das HLRS eines der drei Bundeshöchstleistungsrechenzentren.
